十引擎同板对垒:y26n 双冠的赢法是砍 NMS
五模型十引擎同一条流水线:y26n INT8 165.7 FPS 双冠,但推理段并不最快——赢在把 NMS 从 2.3ms 砍到 0.45ms。附三反直觉和选型卡。
本页目录
选型这事吵不出结果,跑分可以。五个检测模型、FP16/INT8 两档、十个 TensorRT 引擎、同一条流水线、同一张测试图——让数字自己排队。摸底篇看过板子的底,这篇给选型答案。
十引擎全表
| 模型 | 精度 | FPS net | 量化收益 | TJ 峰值 | 负载功率 |
|---|---|---|---|---|---|
| yolo26n | INT8 | 165.71 | +12.0% | 81℃ | 5.62W |
| yolo26n | FP16 | 147.94 | — | 84℃ | 6.54W |
| yolov8n | INT8 | 137.16 | +13.7% | 66℃ | 5.12W |
| yolov8n | FP16 | 120.64 | — | 67℃ | 6.12W |
| yolo11n | INT8 | 130.77 | +12.1% | 67℃ | 5.03W |
| yolo11n | FP16 | 116.62 | — | 68℃ | 5.87W |
| yolo12n | FP16 | 88.10 | — | 82℃ | 6.44W |
| yolo12n | INT8 | 85.18 | -3.3% 倒挂 | 82℃ | 5.89W |
| rtdetr-l | INT8 | 42.74 | +27.3% | 96℃ | 8.24W |
| rtdetr-l | FP16 | 33.57 | — | 97℃ | 9.46W |
双冠的赢法:不是算力,是砍了 NMS
y26n INT8 的推理段 3.69ms,比 v8n 的 3.06ms 还慢——冠军全部来自端到端头把 NMS 从 2.32ms 压到 0.45ms(-80%)。一进一出,单帧净省 1.25ms = 净赚 28.6 FPS。“端到端头"三个字在边缘端的含金量,就这么定量。
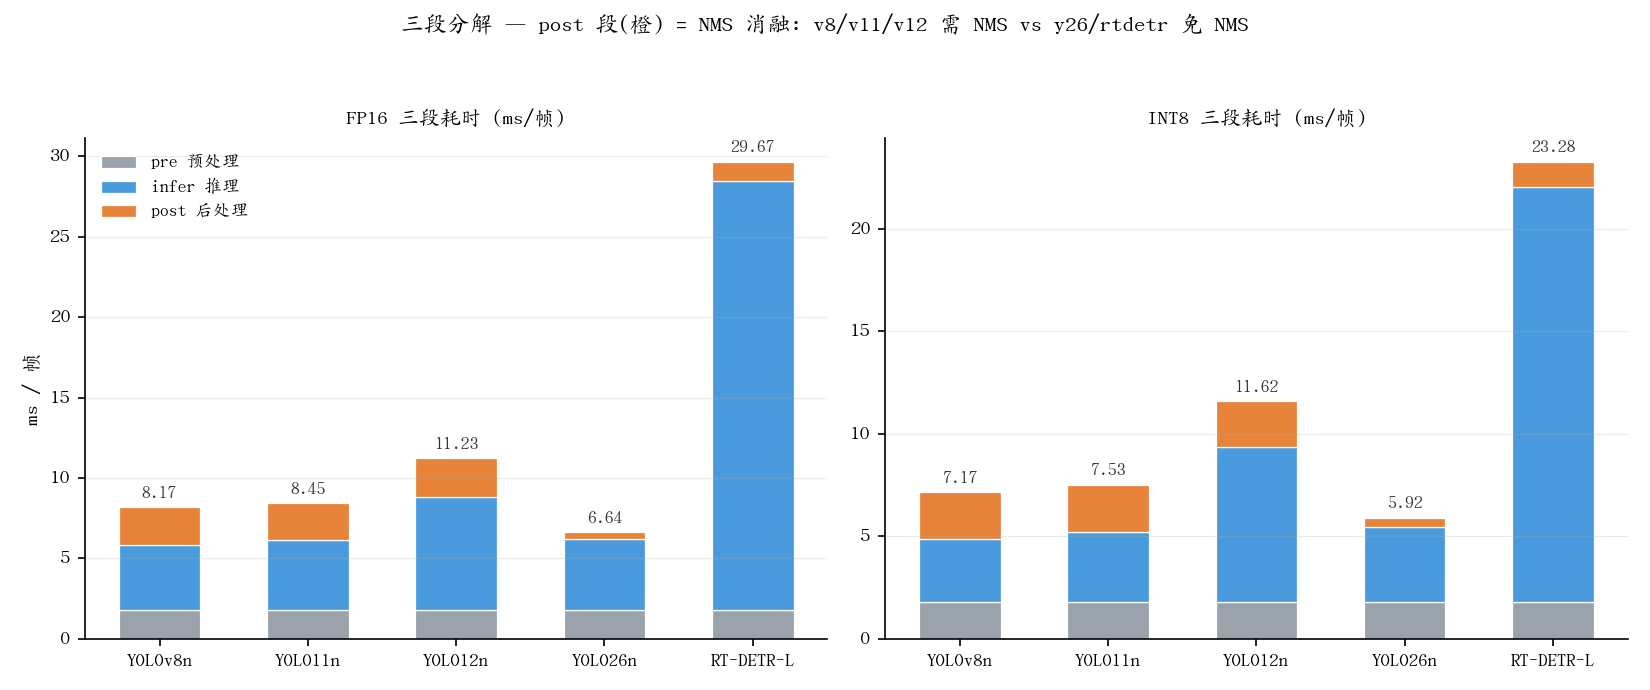
一个口径陷阱必须说透:“谁的推理更快"取决于你量哪一段。trtexec 裸 compute 口径 y26n 全场最快(3.49 vs v8n 3.91ms);流水线 infer 段(含数据搬运)v8n 反超(3.06 vs 3.69ms)。两个口径排序相反,都是真的——选型结论只落在整帧账单上,单段数字会骗人。
INT8 三个反直觉
- 量化不是万能药:v12n INT8 比 FP16 倒退 3.3%(85.18 vs 88.10),attention 架构在这类边缘 GPU 上两头没红利。
- INT8 没弄坏框,但弄缩了分数:双口径一致率检查里 strict 口径全员 0.2,逐框诊断证明不是实现错误——熵校准把 conf 整体下压(0.89→0.57),框 IoU 全 >0.9。部署后果:INT8 上线 conf 阈值必须重调,沿用 FP16 的会漏检。
- transformer 的 conf 反而最稳:rtdetr-l 是唯一 strict=box 的模型(0.71/0.71)——加分项归加分项,但 42.7 FPS、能效只有 1/6、96-97℃,精度刚需才上。
能效榜
榜首 y26n INT8 29.47 FPS/W,垫底 rtdetr-l FP16 3.55——差 8.3 倍。同一个 COCO 检测任务,每瓦特买到的帧数差一个数量级。无风扇机柜、电池、太阳能场景,FPS/W 是硬通货,“选对模型"比"换好电源"值钱。
选型结论卡
| 你的场景 | 选它 | 依据 |
|---|---|---|
| 追极限 FPS / 电池供电 | y26n INT8 | 165.7 FPS + 29.5 FPS/W 双冠 |
| 生态最熟、求稳 | v8n INT8 | 137.2 FPS,部署链最成熟,conf 记得重调 |
| 想上 attention 架构 | v12n 本板劝退 | FP16 88 且 INT8 倒挂,两头没红利 |
| 精度刚需 / 免 NMS | rtdetr-l INT8 | 42.7 可用,能效 1/6,97℃ 散热掂量 |
速度榜不是质量榜:本横评没自测 mAP(没搭验证集,不编数),官方参考值 y26n 40.9 / v11n 39.5 / v8n 37.3(val 口径,未自测)。速度冠军必须在你自己的数据上复检质量才算数。
这块板到底是什么
十引擎跑完,回到那个问题:这套东西能干什么。分三档:
- 今天就有价值:算法选型验证、原型迭代、产线旁路监督(人在环)、教学演示——决策有人兜底,错了马上改。
- 补强后可用:定制检测(数据闭环 1-2 周)、接 PLC(2-4 天)、7×24 无人值守(自启 + 看门狗,2-3 天)、计量任务(标定 + 全局快门,3-5 天)。
- 别硬上:安全回路、计量仲裁、亚毫秒硬实时主控、恶劣环境无人维护——那不是软件问题,是平台形态和认证体系问题。
一句话:这块板现在是工程师的工作台,不是产线设备——但工作台到设备之间隔的是一圈明码标价的工程量,不是技术鸿沟。
环境口径:Jetson Orin Nano Super 8GB / JetPack 6 / TensorRT 10.7 / CUDA 12.6;锁频 1020MHz 满频占比 100%,每引擎 900 帧串行单跑,预热帧剔除;测试图 bus.jpg(810×1080)为 ultralytics 官方示例图;2026-11 实测。