从 43 到 165 FPS:钱都花在哪
同一块板同一段视频,43.5→143.9→165.3 FPS。拆账:换引擎只值 ×1.15,大头是零拷贝取流和双线程解耦。附单帧账单和三个坑。
本页目录
网上教程在这块 Orin Nano 上跑 40 FPS,我的流水线跑 165。差距不在硬件,在钱花没花对地方。这篇把账单拆开:每级台阶提速多少、钱花在哪,全部摊开。
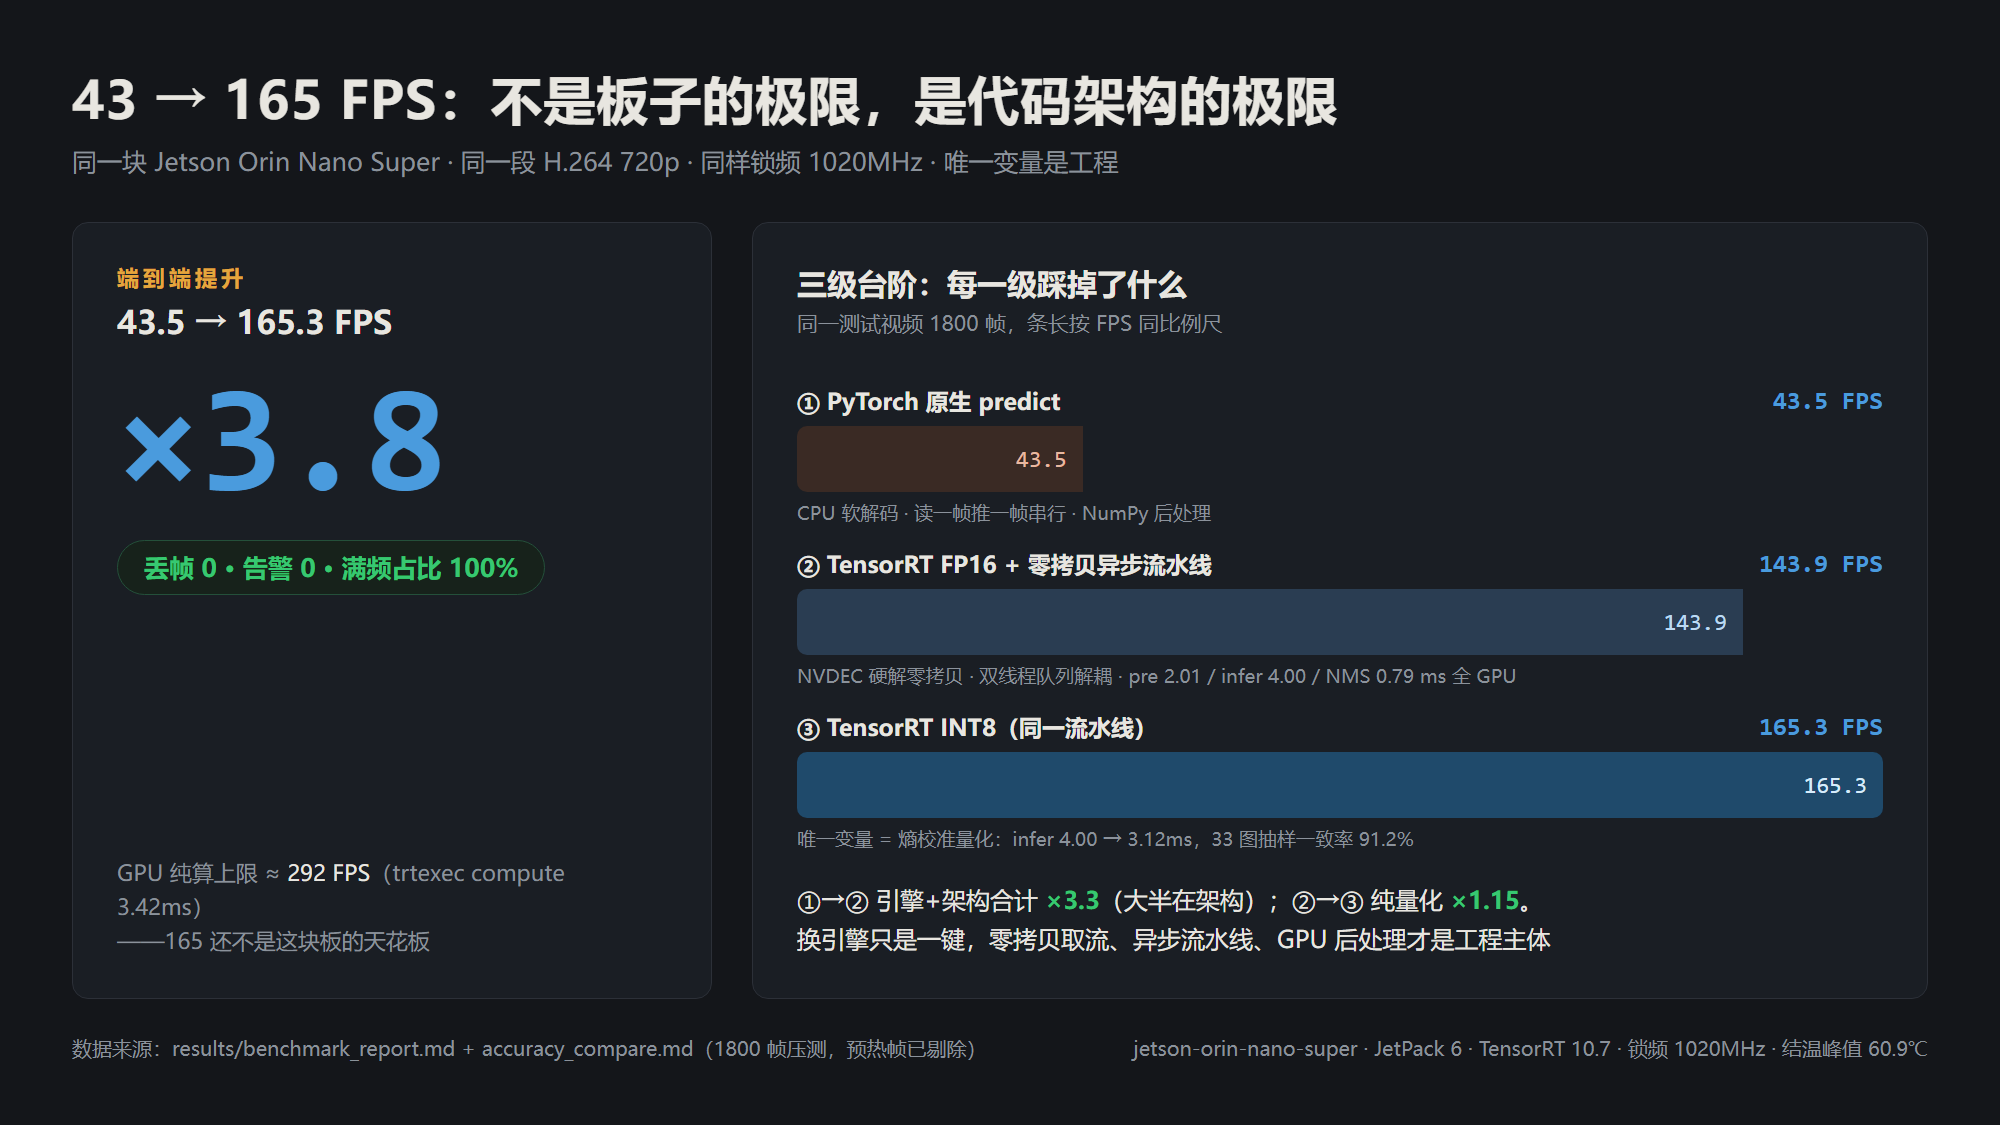
三级台阶的账单
| 台阶 | FPS | 单帧预算 | pre/infer/NMS (ms) |
|---|---|---|---|
| ① PyTorch 原生 predict | 43.5 | 23.0 | 没分过段 |
| ② TensorRT FP16 + 零拷贝流水线 | 143.9 | 7.0 | 2.01 / 4.00 / 0.79 |
| ③ 同流水线换 INT8 引擎 | 165.3 | 6.05 | 2.01 / 3.12 / 0.73 |
两笔账一眼看穿:
- ①→② 合计 ×3.3,但引擎和架构是同时换的,中间没留测量点——谁报一个精确比例都是在编。能钉住的量级是:165 FPS 时推理只占 3.12ms,一半预算是流水线替你省出来的。
- ②→③ 只有 ×1.15,干净的一跳:唯一变量是熵校准量化,infer 4.00→3.12ms,其他段一字未动。换引擎是一键的事,零拷贝取流、双线程解耦、GPU 前后处理才是工程主体。
流水线值多少钱,还有个同引擎对照:同一个 v8n INT8 引擎,我的专用流水线 165.3 FPS,横评为了五模型同口径的通用流水线只有 137.2——推理段 3.12 vs 3.06ms 几乎相同,28 FPS 就是流水线优化的定量价格。
43.5 的三个浪费点
教程标准三行代码——VideoCapture 软解、串行读一帧推一帧、NumPy 后处理——藏着三件事:
- CPU 软解码:板上有独立硬件解码器 NVDEC 在闲着,CPU 却在拼命解 H.264
- 串行阻塞:解码时 GPU 闲,推理时解码器闲,两个硬件轮流打工
- CPU 后处理:letterbox 和 NMS 在 Python 循环里跑
三条没有一条是"模型太慢"——模型从头到尾没换过。逐一反转,就是这条流水线:
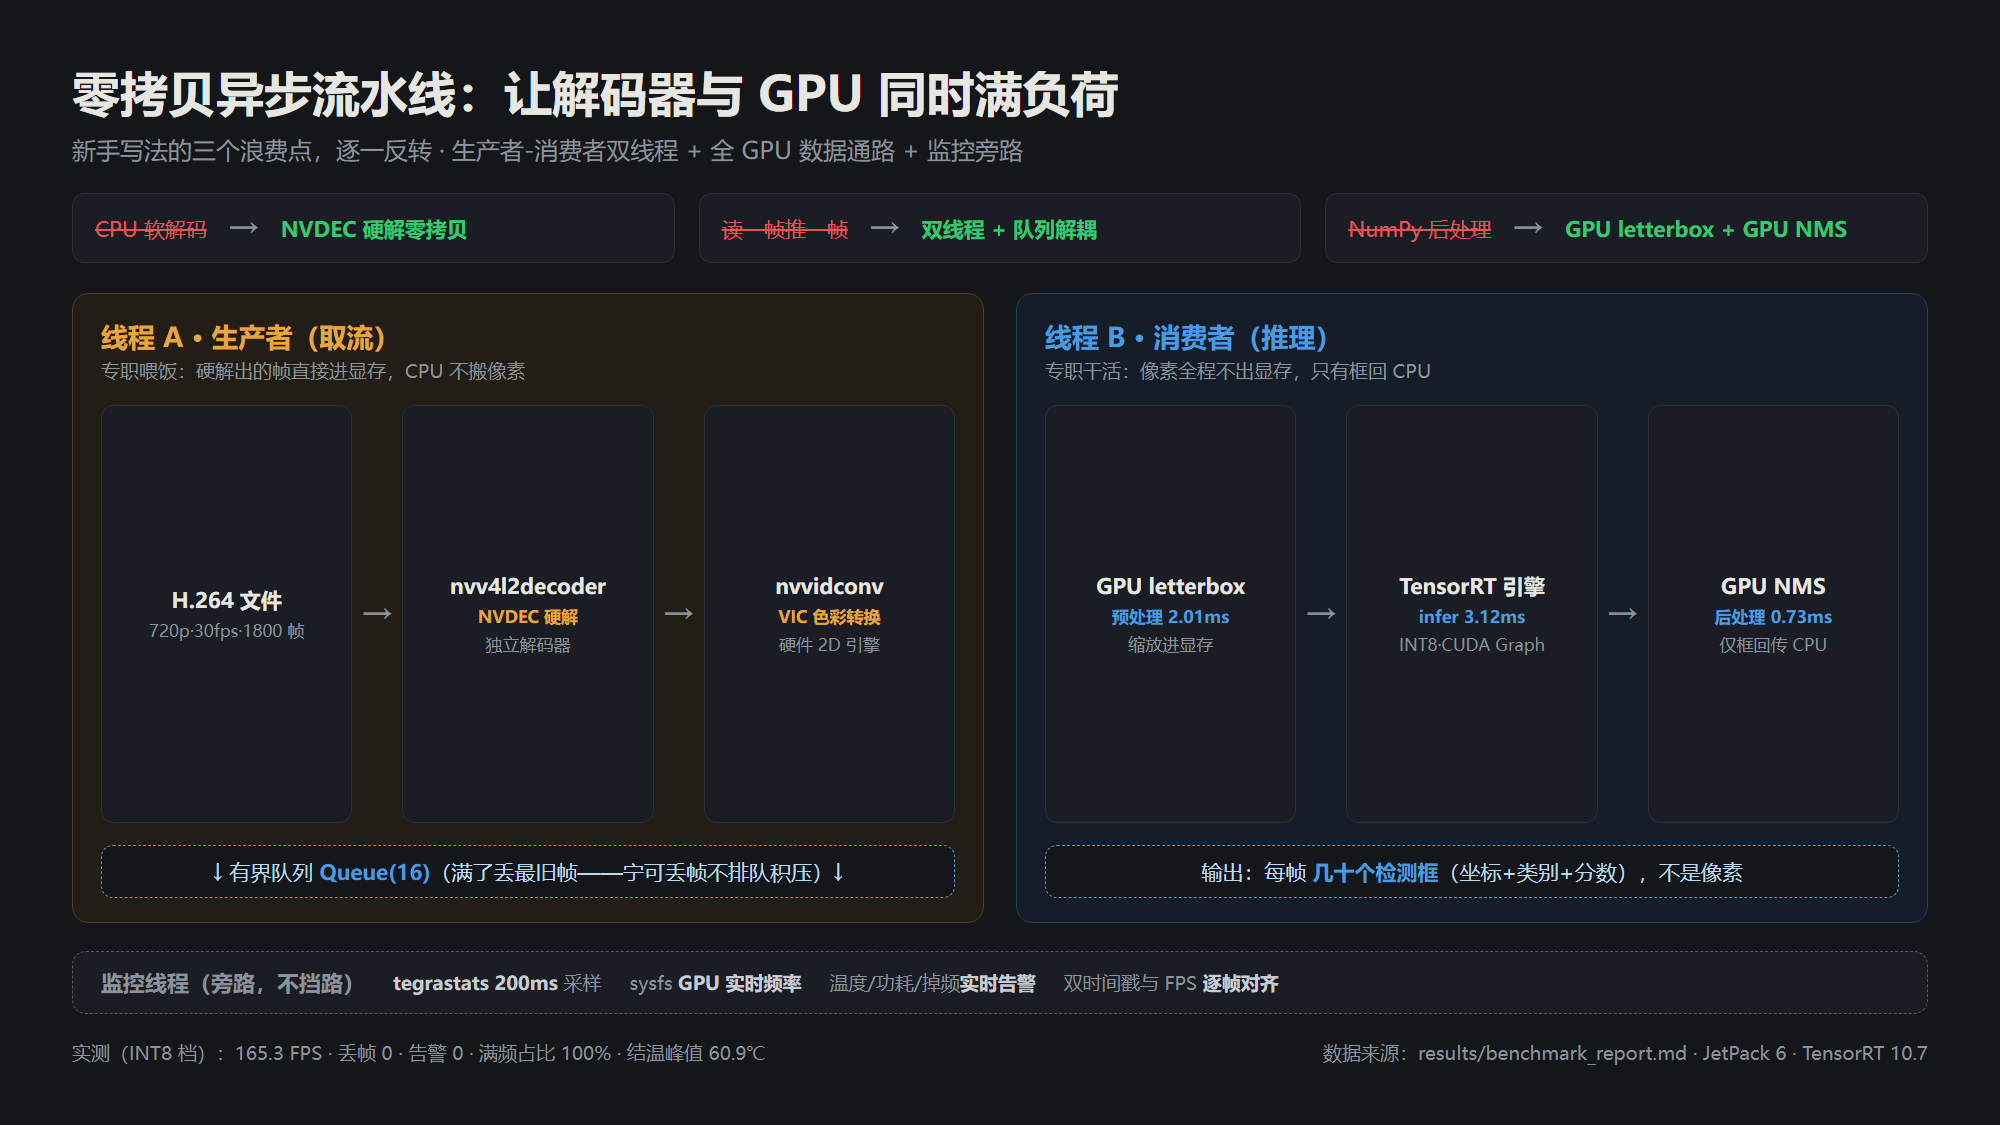
NVDEC 硬解 + VIC 色彩转换,显存直通,CPU 从头到尾没搬过一个像素;线程 A 取流、线程 B 推理,中间 Queue(16) 解耦,满了丢最旧帧(检测场景里最新帧永远比旧帧值钱);letterbox 和 NMS 全上 GPU,每帧回 CPU 的只有几十个框。
怎么测的
- 同一段 720p H.264(1800 帧),NVDEC 硬解取流,逐帧分段计时
- 锁频 1020MHz + DVFS 关闭,满频占比 100%,跑分期间一次降频都没有
- 每段计时后
torch.cuda.synchronize()——GPU 计时不同步,出来全是微秒级假数据 - 预热帧和停顿帧剔除:早期统计里"最低 11.9 FPS"就是停顿帧污染出的假象,不是流水线慢,是口径脏
INT8 上线前的两件事
速度的账算完,必须回答精度掉没掉。33 张真实照片双引擎对检:IoU>0.5 且同类的抽样一致率 91.2%,框数 1.4→1.1/图,几何质量没崩。两点别装看不见:
- 这是抽样一致率,不是 mAP——正式精度评测是另一回事,这里不越界下结论
- INT8 置信度会系统性下移(熵校准的典型副作用,框没坏、分数缩水),conf 阈值必须用自家数据重调,沿用 FP16 的 0.25 会漏检
校准集也别偷懒:合成图校出来的量化范围是失真的,必须用真实照片。
最阴的坑:无声卡死
GStreamer 的 bus 消息需要一个在跑的主循环来分发。写成回调、又没起主循环,程序就"顺利地"停在那里——无报错、无输出、无异常。我在"程序是死了还是跑完了"上耗过半天,最后用 bus.pop_filtered() 轮询收掉。教训:观测仪器先行(打印、计数器、日志),别先怀疑代码。
还有多少余量
trtexec 压测 GPU compute 3.42ms,折算纯推理上限约 292 FPS。165 不是这块板的天花板,是取流和前后处理还占着时间。顺带一提:INT8 比 FP16 整板功耗更低(16685→15286mW),跑得更快、还更省电。
环境口径:Jetson Orin Nano Super 8GB / JetPack 6 / TensorRT 10.7 / CUDA 12.6,2026-11 实测。